扩散模型:发展脉络
扩散模型的发展可以放在一条连续主线上看:DDPM 解决如何稳定训练高质量生成模型,DDIM / ODE solver 解决如何更快采样,Consistency / LCM / DMD / Rectified Flow 继续追问能否把几十步甚至几百步压到几步或一步。
统一记号
后文统一使用这组记号:
读作:噪声 从标准高斯分布采样;括号里的第 1 个参数 是均值,表示噪声整体不偏向正或负;第 2 个参数 是单位协方差,表示每个维度独立、方差为 1。
在 DDPM 文献中常见等价写法是:
可以理解为真实信号 和噪声 的按时刻混合。扩散模型学习的是如何从噪声状态一步步回到数据分布。
一条主线
扩散模型的发展主要围绕三件事:
- 把生成过程写成更容易训练的逐步去噪问题;
- 把逐步去噪解释成 SDE/ODE 数值求解,引入 Euler、Heun、DPM-Solver;
- 用蒸馏、分布匹配、Rectified Flow 把多步采样压缩成少步甚至一步。
一个简化路线是:
1 | DDPM |
这条主线主要讲采样路径和步数。另有一条横向脉络围绕表示空间展开:Latent Diffusion 用 VAE 压缩图像,把 denoiser 成本降下来;RAE、VAVAE 等路线继续修 autoencoder;VAE-free / pixel-space diffusion 则直接绕开 autoencoder,把问题交给像素空间训练信号和 token 架构。PixelDiT 与 PixelGen 就落在这条分叉上。
还有一条近年的辅助线索是 DINO / VFM representation alignment。REPA 发现扩散 Transformer 自己也会学出有用视觉表示,但训练早期较弱,于是用 DINOv2 等冻结视觉编码器做外部老师;CREPA、Align4Gen、RefAlign 又把这个想法搬到视频微调、跨帧一致性和参考图视频生成里。它不重写扩散路径,却会改变训练时模型学到的中间表示。
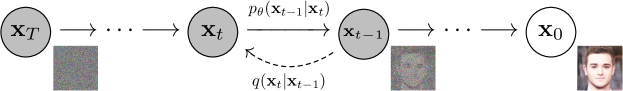
图源:Denoising Diffusion Probabilistic Models,Figure 2。原图表达 DDPM 的正向加噪链和反向去噪链;读图重点是把后续 DDIM、Score SDE、DPM-Solver、Consistency 和 DMD 都看成在这条“从数据到噪声再回来”的路径上重新分配训练、采样和蒸馏成本。它不能证明哪条新路线一定更好,只提供共同坐标系。
常见误区:新方法不是简单替代旧方法。
这条时间线更像一组不同代价分配方式,而不是“后来的名字自动淘汰前面的名字”。DDIM 主要改采样路径,DPM-Solver 主要改数值求解,Consistency / LCM 更依赖新的训练或蒸馏目标,DMD 关注生成分布对齐。读论文时先问“它动的是训练、采样、蒸馏还是分布匹配”,比先记年份更有用。
时间线
| 时间 | 方法 | 解决的问题 | 代表意义 |
|---|---|---|---|
| 2020 | DDPM | 训练稳定、生成质量高但采样慢 | 扩散模型主流化起点 |
| 2020 | DDIM | 不重训减少采样步数 | 从马尔可夫链走向确定性路径 |
| 2020 | Score SDE / Probability Flow ODE | 连续时间统一视角 | 采样变成微分方程求解 |
| 2022 | EDM | 系统整理噪声参数化和采样设计 | 工程采样器设计成熟 |
| 2022 | DPM-Solver / DPM-Solver++ | 高阶 diffusion ODE 求解 | 10 到 20 步高质量采样 |
| 2023 | Consistency / LCM | 学习一步或少步一致映射 | 少步生成进入实用区间 |
| 2023 | DMD | 分布匹配式一步蒸馏 | 从轨迹模仿转向分布对齐 |
| 2024 | DMD2 / Rectified Diffusion | 改善一步生成质量和稳定性 | 少步/一步生成继续逼近教师 |
| 2024 | REPA | 用冻结视觉编码器对齐扩散中间表示 | DINOv2 等视觉先验进入 DiT 训练 |
| 2025 | Phased DMD | 分阶段分布匹配 | 在复杂任务中兼顾质量和多样性 |
| 2025 | CREPA / Align4Gen | 把表示对齐扩展到视频扩散 | 关注跨帧语义一致性和视频特征训练 |
| 2025 | PixelDiT | 用 dual-level DiT 做像素空间扩散 | VAE-free 图像生成重新接近 latent DiT 质量 |
| 2026 | PixelGen | 用 LPIPS 和 DINO 感知监督训练像素扩散 | 把像素扩散目标从完整像素流形推向感知流形 |
| 2026 | Z-Image-Pixel | 先 latent pre-training,再 pixel post-training | VAE-free 从“新底座路线”扩展为“最终生成器路线” |
DDPM 到 DDIM
DDPM 的核心是正向逐步加噪,反向学习逐步去噪。训练时通常预测噪声、 或 velocity,把难的生成建模转成监督学习式的去噪问题。
它的价值是训练稳定、质量高、与 score matching 和变分推断建立联系;代价是采样常需几百到上千步,部署时延迟很高。
DDIM 的关键贡献是改变采样路径,而不是重训模型。它证明可以在兼容 DDPM 训练框架下构造非马尔可夫反向过程,并在特定设置下近似确定性采样。这让扩散采样从“逐步反马尔可夫链”走向“沿连续轨迹做离散积分”。
ODE Solver 时代
Score SDE 和 probability flow ODE 把扩散模型放进连续时间框架。采样可以被理解为逆时间 SDE 或确定性 ODE 的数值求解。
这带来一个直接工程收益:同一个训练好的模型,换更好的求解器就能更快出图。
| 求解器 | 特点 |
|---|---|
| Euler | 一阶、简单、每步便宜,低步数误差较大 |
| Heun | 二阶 predictor-corrector,更稳但每步更贵 |
| DPM-Solver | 针对 diffusion ODE 设计的高阶求解器 |
| DPM-Solver++ | 改善 classifier-free guidance 下的稳定性 |
| EDM sampler | 系统整理噪声参数化和采样细节 |
这一阶段的核心不是改变模型训练,而是把采样当作数值分析问题。
蒸馏与一致性
少步采样进一步依赖蒸馏和一致性学习。Progressive Distillation 把多步模型逐级压缩成更少步;Consistency Models 和 LCM 直接学习不同噪声水平之间的一致映射,让模型能在很少步内到达数据分布。
这类方法的核心取舍是:
- 步数更少,速度更快;
- 训练目标更复杂;
- 可能损失多样性或细节;
- 对 teacher、数据和噪声日程更敏感。
少步模型的验收不能只看单张视觉效果,还要看多样性、文本对齐、结构稳定和不同 guidance 强度下的表现。
DMD 与分布匹配
DMD(Distribution Matching Distillation)代表了一条从轨迹模仿转向分布对齐的路线。它不只要求 student 逐步模仿 teacher 的去噪轨迹,而是更直接地让 student 生成分布对齐 teacher / data 分布。
DMD2 继续改善一步蒸馏中的模糊、训练不稳和细节不足;Phased DMD 则把分布匹配分阶段进行,试图在复杂生成任务中兼顾结构、细节和多样性。
这条路线的吸引力很明确:如果能用一步或极少步达到多步扩散质量,推理成本会大幅下降。但它也更容易暴露 teacher bias、模式坍缩和分布覆盖不足。
Latent 表示到 VAE-free 像素空间
Stable Diffusion 以后,latent diffusion 成了高分辨率生成的默认工程形态。VAE 带来的压缩让 U-Net、DiT、Flow 和少步蒸馏都更容易做大,但它也会把细文字、线条、纹理和局部编辑背景先压坏。后端 denoiser 只能在这个表示上继续工作。
VAE-free pixel diffusion 重新打开早期像素扩散的问题。PixelDiT 的回答偏架构:把 patch-level semantic modeling 和 pixel-level texture refinement 分开,用 Pixel Token Compaction 避免 dense pixel attention 失控。PixelGen 的回答偏训练信号:模型仍直接在像素空间预测 clean image,但额外用 LPIPS loss 和 DINO 感知 loss 约束局部纹理与全局语义,让学习目标更接近人真正会看的 perceptual manifold。
Z-Image-Pixel 又给出第三种回答:不要强迫 pixel space 承担全部 pre-training。论文在相同 backbone、相同 token grid、相同数据与训练预算下比较 latent 和 pixel pre-training;即使使用超过 20B 图文对,pixel model 仍明显收敛更慢。于是训练被拆成两段:先借助 VAE latent 高效学习视觉知识和文本对齐,再把共享 Transformer 迁移到 RGB,用 self-generated + real data 做 pixel post-training。VAE 在前期是表示学习工具,最终部署链路则可以不再包含 VAE。
因此它们不应和 DDIM、DPM-Solver 或 DMD 放在同一个比较维度里。DDIM 和 solver 改采样路径,DMD 改少步学生的分布匹配,PixelGen 和 PixelDiT 改的是图像在哪个空间被建模,Z-Image-Pixel 进一步改变这种表示空间在训练流程中的启用阶段。一个系统可以同时是 latent-pretrained、VAE-free at inference、Flow Matching、DiT 主干和少步蒸馏模型。
DINO 与生成模型的表示对齐
DINO 进入扩散生成,通常不是作为一个新的生成器,而是作为冻结视觉表征。REPA 把 noisy hidden state 的投影对齐到 clean image 的 DINOv2 等特征,让 DiT / SiT 更快学到视觉结构。PixelDiT 用这条路线稳定 patch-level 语义,PixelGen 则把 DINO 放到 perceptual loss 里,让像素扩散少拟合不可感知噪声,多关注全局语义。
视频里这件事更难。逐帧 DINO 对齐可以强化主体和布局,但未必保证相邻帧同一个人还沿着同一条运动轨迹走。CREPA 的思路就是把对齐从单帧扩到 cross-frame;Align4Gen 进一步比较不同自监督视觉编码器是否同时具备 discriminability 和 temporal consistency。这里的关键判断是:DINO 提供的是视觉表征先验,时间一致性还要通过抽帧、邻帧对齐、视频指标和真实回放来验证。
Rectified Flow 与收口判断
Rectified Flow / Rectified Diffusion 试图学习更直的生成路径,把噪声到数据的传输路径整流,从而减少采样步数。它和 DMD、consistency、LCM 都指向同一个工程目标:少步甚至一步生成。
理解扩散演化时,不必把每个方法割裂成独立名词。更实用的判断是:
- 它改变训练目标,还是只改变采样器;
- 它减少步数的代价是什么;
- 它是否保持多样性、结构和条件对齐;
- 它是否在真实分辨率、真实 prompt 和真实延迟预算下成立。
扩散模型的发展主线,就是在质量、步数、稳定性和多样性之间不断重新分配代价。
外部材料
- Title: 扩散模型:发展脉络
- Author: Charles
- Created at : 2025-05-06 09:00:00
- Updated at : 2025-05-06 09:00:00
- Link: https://charles2530.github.io/2025/05/06/ai-files-diffusion-evolution/
- License: This work is licensed under CC BY-NC-SA 4.0.