论文专题讲解:H-JEPA:层级 JEPA 与潜变量 EBM
论文题名: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence。
作者: Anna Dawid、Yann LeCun。
机构: 未在公开元数据中稳定解析;以 arXiv/PDF 或官方页 affiliation block 为准。
时间 / 主题: 2023-06;世界模型。
arXiv / 官方报告: arXiv:2306.02572。
GitHub / 项目: GitHub:未找到官方链接。
元数据来源与核验口径: 来源:arXiv;Checked Date:2026-06-15;Repro Status:Paper / official materials reviewed, independent reproduction not claimed。
原论文故事线
研究背景
H-JEPA 这篇文章是 LeCun 世界模型路线的理论/教学型展开。它的背景是:如果智能系统要像人和动物一样从观察中学习世界、在行动前想象结果、并在多个时间尺度上规划,单纯的监督学习、强化学习或像素级生成模型都不够。高维连续世界有大量不可预测细节,显式概率建模和像素重建会把容量浪费在与决策无关的信息上。
论文因此引入 energy-based model、latent variable 和 joint embedding predictive architecture。它不是在刷 benchmark,而是在解释一种世界模型训练原则:在表征空间预测未来或缺失部分,用能量衡量兼容性,用 latent variables 表达不确定性,用层级结构支持长时规划。
问题(Challenge)
论文要解决的问题是:如何训练一个既能处理不确定性、又不被像素细节拖累、还能服务层级规划的世界模型? 挑战有三点。第一,高维输入下未来往往多模态,模型不能只输出平均结果。第二,如果 latent variable 容量不受限,它会把目标信息偷带过去,造成能量坍缩。第三,短期低层预测和长期高层规划需要不同抽象粒度,单层表示很难同时满足。
这个问题有价值,因为世界模型最终要服务行动,而行动需要预测“对目标有用的未来状态”,不是重建所有不可控细节。H-JEPA 试图给出一个从 self-supervised representation learning 到 planning 的中间理论桥梁。
Finding
作者的 finding 是:世界模型应当在 joint embedding space 中预测可规划的抽象状态,并用 energy + latent variables 表达兼容性和多种可能未来,而不是直接生成高维观测。 这个洞见把“预测未来”从像素空间转移到表示空间,也把 uncertainty 从单一分布预测转移到 latent variable inference。
这个 finding 能解决挑战:表示空间可以丢掉无关细节,减少生成负担;energy function 可以给多个合理未来低能量,而不是强迫模型选一个平均未来;latent variable 可以表示姿态、光照、遮挡、他人意图等 中不可见但影响 的因素;层级 JEPA 则让低层处理短期局部变化,高层处理长期抽象计划。
方法
论文先介绍 EBM:模型学习能量函数 ,兼容的输入输出对能量低,不兼容的能量高;推理时寻找低能量 。再加入 latent variable ,用 表达同一 关系中的隐藏解释因素,并通过对 最小化或边缘化得到有效能量。训练时关键不是只降低真实样本能量,而是塑造能量景观,避免所有输出都低能量。
JEPA 部分把输入 和目标 编码成 embeddings,predictor 根据 的表示和 latent variable 预测 的表示,用表示距离作为能量。H-JEPA 进一步把这种预测结构做成层级:不同层级的 representations 对应不同抽象粒度和时间尺度,低层捕捉局部感知,高层支持更长 horizon 的 planning。论文把它放进 perception-world model-actor-cost-critic 的自主智能架构中。
结论
这篇文章没有给出一个训练完成的 H-JEPA benchmark,而是给出概念推导和设计约束。它的结论是:为 autonomous machine intelligence 构造世界模型时,EBM、latent variables、JEPA 和 hierarchy 可以共同处理三个问题:高维连续预测中的不确定性、生成式模型的信息冗余、以及长时规划需要的抽象层级。
需要额外说明的是,H-JEPA 作为论文中的方向并不等于已有可部署 agent。它还缺少具体可复现训练 recipe、动作/reward/done 闭环实验和大规模规划评估。它对世界模型专题的价值是定义了另一种“预测表征而非像素”的范式,并提醒我们世界模型的状态空间应当围绕可预测、可规划、可压缩的信息组织。
关键术语
- Energy-Based Model, EBM(能量模型):用能量函数表示输入输出是否兼容,低能量表示合理,高能量表示不合理。
- Latent Variable(潜变量):表示输入中未直接观察到、但影响输出预测的隐藏因素,如姿态、光照、意图或多种未来选择。
- Joint-Embedding Predictive Architecture, JEPA(联合嵌入预测架构):在表示空间预测目标 embedding,而不是直接重建原始观测。
- Hierarchical JEPA, H-JEPA(层级 JEPA):在多个抽象层级和时间尺度上做 JEPA 式预测的世界模型设想。
- Energy Collapse(能量坍缩):模型把所有输出都赋予低能量,导致能量函数失去区分能力的问题。
- Perception-Planning-Action Cycle(感知-规划-行动循环):感知估计当前状态,世界模型预测未来,actor 搜索动作,cost/critic 评估未来的闭环结构。
这篇文章不是一篇“训练出某个 H-JEPA 模型并刷榜”的论文。它更像一篇把 LeCun 世界模型路线讲清楚的教学型论文:先解释为什么高维连续世界不适合只靠显式概率建模,再引入 energy-based model、latent variable、JEPA 和最终的 H-JEPA。
放在世界模型专题里,它的价值是补上一个关键问题:如果世界模型不直接生成未来像素,而是在表征空间里预测未来状态,训练时到底要约束什么,为什么会坍缩,以及为什么需要层级结构。
论文位置
论文沿用 LeCun 提出的自主智能架构。这个架构不是把模型看成一个端到端 policy,而是拆成 perception、world model、actor、cost/critic、short-term memory 和 configurator 等模块。
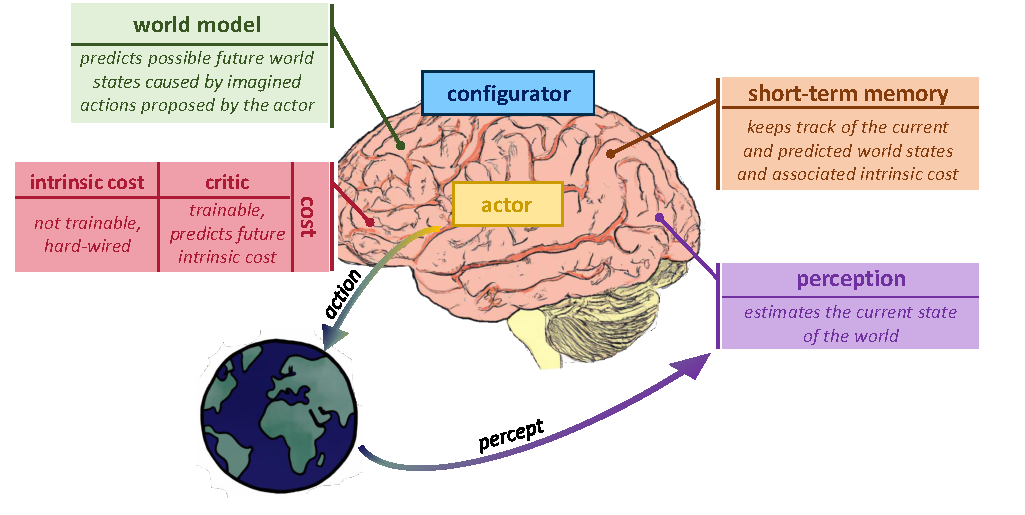
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 1. 原论文图注要点:该图展示 LeCun 提出的 modular autonomous AI 结构,其中 world model 负责预测 actor 设想动作导致的未来世界状态,short-term memory 维护当前与预测状态,cost/critic 评估这些状态。
自主智能架构图先找 world model 的位置。
输入输出:输入是 context/target 表征和层级 latent,输出是 joint embedding prediction 与能量式目标。
效率机制:在 embedding 空间预测,减少像素重建冗余并鼓励抽象状态学习。
对主线意义:它补强“世界模型可以预测表征而非像素”的理论路线。
不能证明什么:JEPA 表征本身不证明有 action/reward/done 或可规划 rollout。
这张图里最重要的是 world model 的位置。它不是直接回答“下一步动作是什么”的 policy,而是回答:
然后 actor 可以通过 cost/critic 评估这些未来,选择更低 cost 的动作序列。这和 Dreamer 系列的 latent imagination 有相通处,但这篇文章的重点不是 RL 算法,而是解释世界模型的表示和训练目标应该如何设计。
为什么引入 EBM
传统生成式模型常把预测写成概率分布:
但高维连续数据里,未来往往是多模态的。例如给定一段视频历史,未来可以有很多合理发展;给定同一个路口状态,其他车辆可能减速、直行或转向。如果强行预测一个像素级结果,模型会被迫解释大量不可预测细节。
EBM 的思路是不直接要求模型给出规范化概率,而是学习一个能量函数:
兼容的 应该有低能量,不兼容的 应该有高能量。推理时寻找低能量的 :
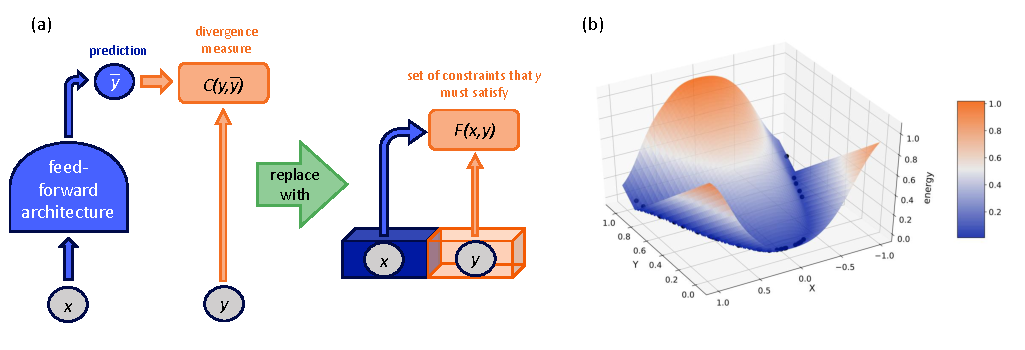
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 3. 原论文图注要点:作者用 EBM 替代显式概率预测,把问题转成寻找满足输入约束的低能量输出;图中还展示了一个学习到 与 依赖关系的能量景观。
能量图应该怎么读。
EBM 图里的纵轴不是概率,而是“不兼容程度”。给定输入 ,合理的目标 应该落在低能量区域,不合理的 应该高能量。推理时可以通过搜索、优化或采样去找低能量的 ,不需要模型直接输出一个规范化概率分布。
这对世界模型有两个好处:第一,它允许同一个当前状态对应多个低能量未来,而不是被迫预测一个平均未来;第二,能量可以定义在 representation space,让模型只关心对预测和规划有用的状态关系。读这张图时要避免把低能量理解成“训练样本 loss 低”这么简单;真正要学的是整个能量景观的形状。
这里有一个容易误解的点:energy function 是推理时用来找答案的函数,不等于训练时直接最小化的 loss。 训练 EBM 的目标是塑造整个能量景观:让真实数据附近低能量,让不合理区域高能量。如果只把训练样本能量压低,而不约束其他区域,就会出现低能量区域无限扩张或能量坍缩。
Latent Variable EBM
世界模型需要处理不确定性。仅凭当前观测,很多未来因素并不在 里,例如遮挡物体、他人意图、未观测场景结构、未来随机事件。论文用 latent variable 表达这些不可直接从输入读出的解释因素。
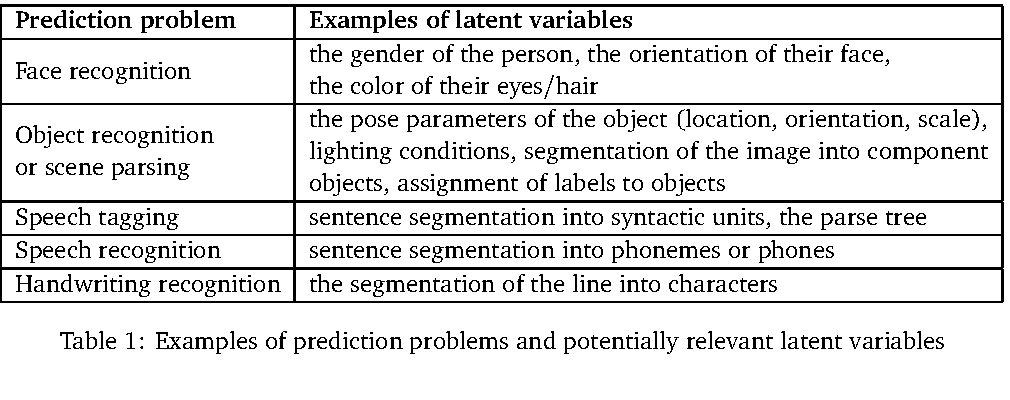
表源:Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence,Table 1。原论文表格要点:表格列举了 prediction problems 中可能相关的 latent variables,例如姿态、光照、分割结构、句法结构和字符分割等。
这张表要按不可观测因素读。
表中每一行都在提醒同一件事:很多预测问题里, 本身不足以唯一决定 ,中间还缺姿态、光照、结构、句法等隐变量。它支撑的是 latent variable EBM 的动机,而不是给出一个固定 latent taxonomy;真实世界模型里的 还要被容量约束,否则会变成偷带答案的通道。
引入 后,模型可以先定义:
再通过对 做最小化或边缘化得到可用于推理的能量:
也可以用 free-energy 式的边缘化形式。直觉是:同一个 可能允许多个合理 ,而不同 对应不同解释路径。
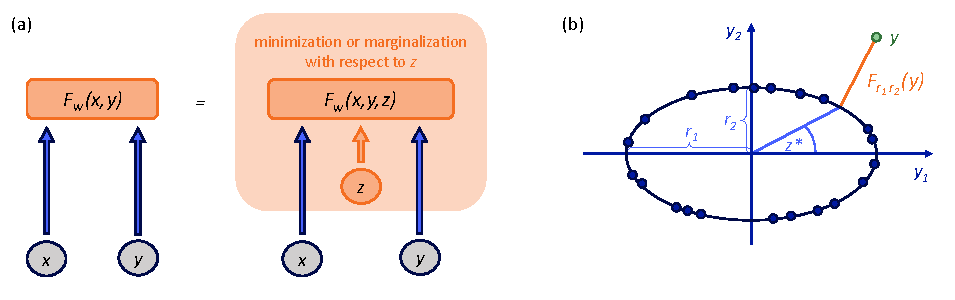
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 4. 原论文图注要点:latent variable EBM 在推理时额外对 latent variable 做 minimization 或 marginalization;右侧椭圆例子说明 latent variable 可以表示数据流形上的隐含角度。
latent variable 在这里不是普通噪声。
图中的 表示输入 中没有显式给出的解释因素。比如当前视频看不到的物体状态、其他 agent 的意图、遮挡后的运动分支,都可能让未来 出现多种合理结果。latent variable EBM 不是直接说“给模型加随机噪声”,而是让推理过程可以为同一个 寻找一个合适的隐含解释。
用 看,就是只要存在某个 能解释 ,这个 就可以低能量;用 marginalization 看,则是把多个解释路径综合起来。对世界模型来说,这比单峰预测更自然,因为真实未来往往是多模态的。
对世界模型来说, 的作用可以理解成:
| 场景 | 应该表达什么 |
|---|---|
| 视频未来预测 | 当前画面无法确定的运动分支、遮挡对象、未观测细节 |
| 自动驾驶 | 其他交通参与者的意图、短期随机行为、不可见区域状态 |
| 机器人操作 | 接触状态、物体内部状态、不可见受力或摩擦条件 |
| 多智能体环境 | 其他 agent 的目标、策略类型和私有信息 |
但 不是越大越好。如果 容量太强,模型可以把所有预测所需信息都塞进 ,从而绕开从 推断 的任务。论文反复强调 latent variable 的信息量必须被限制,否则世界模型会学成“带答案通道的预测器”。
EBM 训练为什么会坍缩
EBM 最大的训练风险是 collapse。在 joint embedding 结构中,如果两个 encoder 都输出常数表示,那么任意 的表示距离都很小,训练误差看起来很好,但模型没有学到任何世界结构。
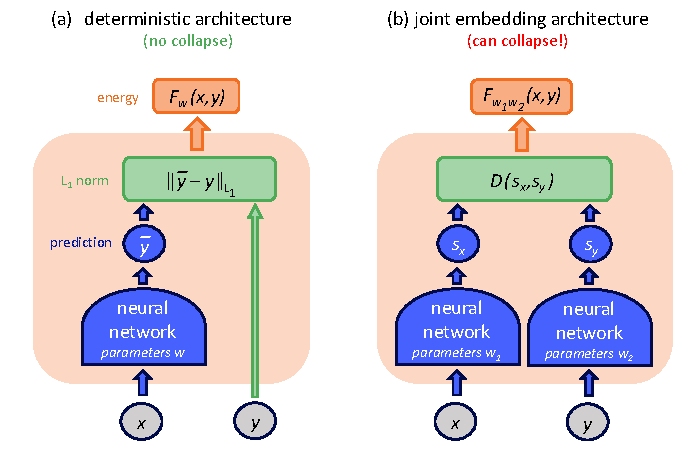
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 5. 原论文图注要点:标准 deterministic prediction 架构不容易发生这种表示坍缩,但 joint embedding architecture 如果只最小化表示距离,就可能让 encoder 忽略输入并输出无信息常数。
collapse 图看的是坏解。
左侧 deterministic prediction 仍要输出目标空间里的内容,常数输出很难骗过任务;右侧 joint embedding 如果只让两个 embedding 接近,两个 encoder 都输出常数也能把距离压低。图里的关键箭头是训练目标本身给了模型一条捷径,所以 JEPA/EBM 需要额外的方差、协方差、信息量或 latent capacity 约束。
这对世界模型尤其危险。一个坍缩的模型可能在训练 loss 上很好看,却无法回答任何反事实问题:
1 | 如果我左转,世界会怎样? |
论文把 EBM 训练概括成“塑造低能量区域”。训练样本附近要低能量,但训练集外、不兼容或不合理的配置不能也低能量。
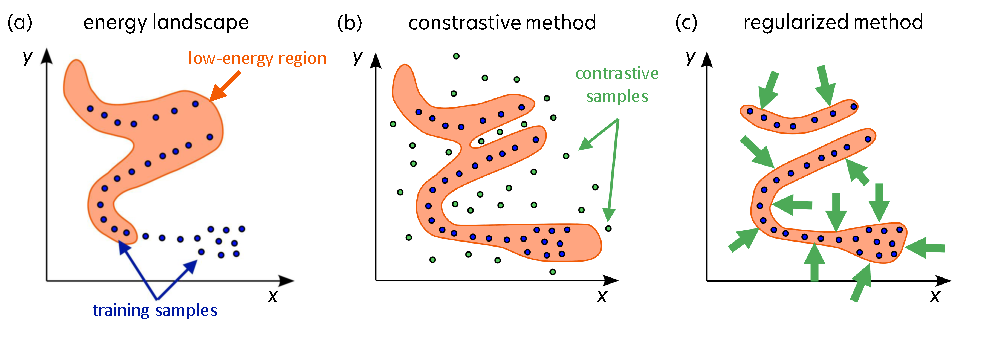
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 6. 原论文图注要点:proper training 要压低训练样本能量并防止 energy collapse;contrastive methods 通过负样本抬高训练集外能量,regularized methods 则限制低能量区域能占据的空间体积。
EBM training 看低能量区域的形状。
左侧目标是让训练样本附近低能量,但不能让低能量区域无限扩张。contrastive 路线靠负样本把不合理区域抬高,regularized 路线靠表示约束限制低能量区域体积。图想说明训练 EBM 不是只把正样本 loss 降低,而是塑造整个能量景观。
论文区分两类训练方式:
| 训练方式 | 基本做法 | 主要问题 |
|---|---|---|
| Contrastive methods | 压低正样本能量,同时抬高负样本或 contrastive samples 的能量 | 高维连续空间里负样本生成和覆盖很困难 |
| Regularized methods | 通过架构或正则项限制低能量区域体积,不完全依赖负样本 | 需要设计能防 collapse 的表示约束 |
这也是为什么 H-JEPA 路线更重视 regularized 和 non-contrastive 训练。世界模型面对的是视频、机器人观测和多模态状态,空间太大,不能假设负样本能覆盖所有不合理未来。
JEPA 的训练目标
JEPA 是把 EBM、latent variable 和 joint embedding 结合起来的一种预测结构。给定输入 和目标 ,两个 encoder 先产生表征:
predictor 再基于 和 latent variable 预测目标表征:
这里 表示预测出来的目标表征, 是输入表征, 是潜变量, 是带参数 的 predictor。
能量由预测表征和目标表征之间的差异给出:
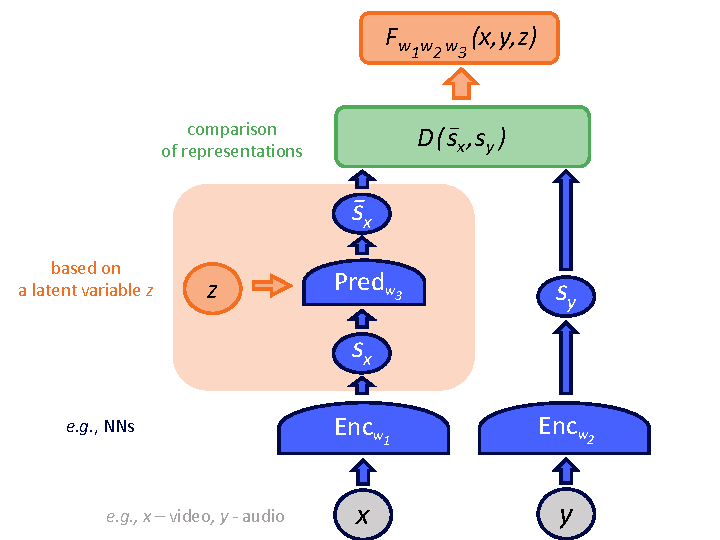
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 9. 原论文图注要点:JEPA 使用两个 encoder 学习 与 的表征,predictor 借助 latent variable 从 预测 ,能量由两种表征之间的距离定义。
JEPA 图先分清三条路径。
经过 context encoder 得到 , 经过 target encoder 得到 ,predictor 再用 和 latent 预测 。训练比较的是 与 ,不是重建 的像素。图想说明的是“预测表征”这条路线,不能直接证明这个表征已经能支持动作规划或奖励预测。
训练 JEPA 不能只最小化 。论文给出的 regularized loss 思路包含三类约束:
- 最小化 prediction error,让 能从 和必要的 中预测出来;
- 最大化 和 对各自输入的信息量,防止 encoder 输出常数;
- 最小化 的信息量,防止 predictor 只依赖 latent variable 搬运答案。
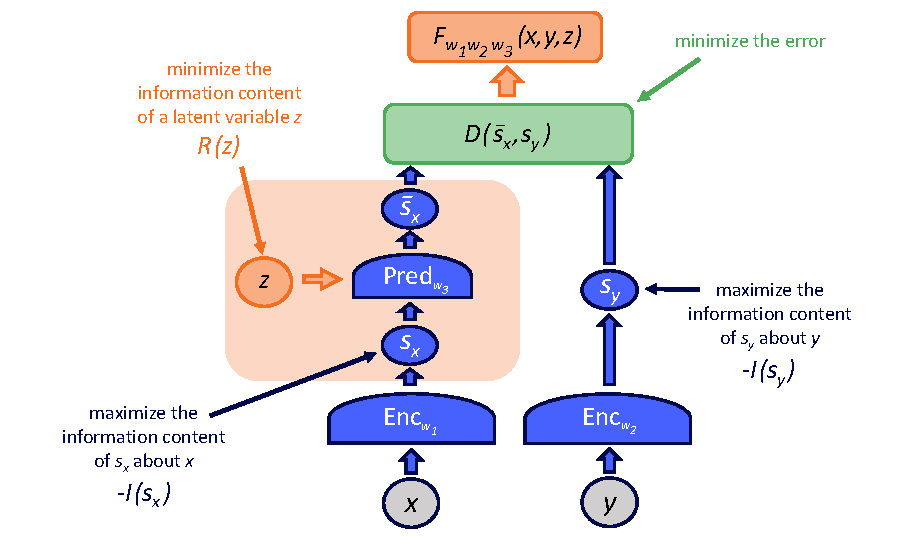
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 10. 原论文图注要点:JEPA 的训练除了 prediction error,还需要让 、 保留输入信息,并限制 latent variable 的信息量;图中把这些正则项和预测误差一起放入训练目标。
regularized loss 同时踩三块刹车。
预测误差让 贴近 ,表示正则防止 、 坍缩成常数,latent 正则限制 把答案全带进去。三者缺一都容易出问题:没有预测误差学不到未来关系,没有表示约束会 collapse,没有 latent 约束会把不确定性通道变成作弊通道。
论文提到的一个具体方向是 VICReg 类正则:通过 variance、invariance、covariance 约束让表示既不坍缩,又减少冗余相关性。这里的重点不是某个固定公式,而是训练原则:预测目标、表示保真和 latent 压缩必须同时存在。
H-JEPA:层级表征世界模型
单层 JEPA 很难同时处理短期细节和长期规划。短期预测需要保留足够多的低层状态,例如位置、速度、局部接触和局部几何;长期预测则不可能精确保留所有细节,反而需要更抽象的状态,例如任务阶段、可达区域、目标关系和风险结构。
H-JEPA 的核心是把多个 JEPA 堆叠起来:
- lower-level JEPA 处理细粒度表示和短期预测;
- higher-level JEPA 使用 lower-level 表示作为输入,做更抽象、更长时间尺度的预测;
- 层与层之间可以用 CNN、pooling 或其他 coarse-graining 模块降低细节密度;
- 每一层都需要自己的 prediction loss、collapse prevention 和 latent capacity control。
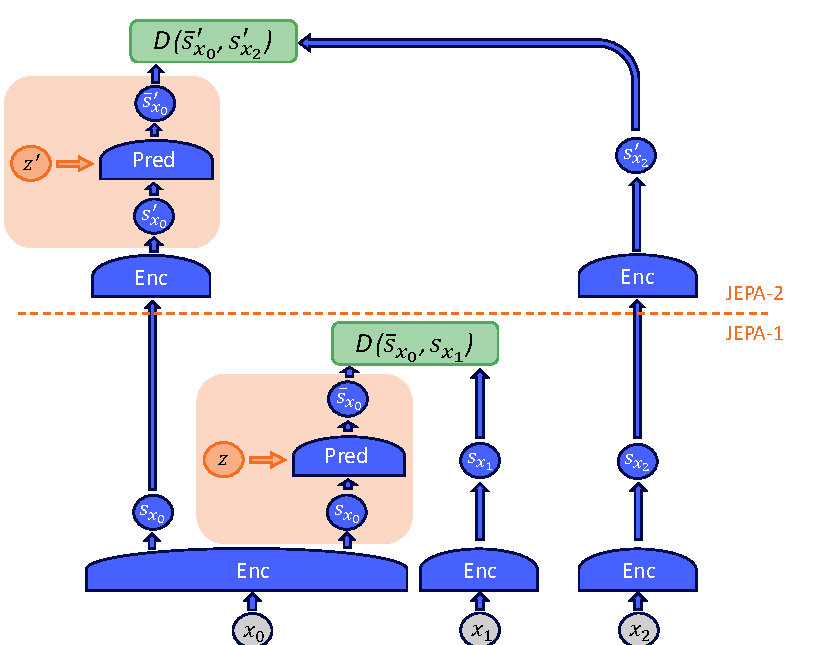
Figure source: Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence, Figure 11. 原论文图注要点:H-JEPA 由堆叠的 JEPA 组成,低层 JEPA-1 基于更多细节做短期预测,高层 JEPA-2 基于更少细节做长期预测,从而支持 multiscale planning。
H-JEPA 图看时间尺度而不是层数炫技。
低层 JEPA 保留更多局部细节,适合短期预测;高层 JEPA 在 coarse-graining 后接收更抽象的状态,适合长时间尺度规划。箭头里的信息逐层变少但语义变粗,这正是它想解决的矛盾:不能用同一套细节密度同时服务接触级短期动态和任务级长期计划。
从世界模型角度看,可以把 H-JEPA 写成多时间尺度预测:
其中第 1 层更接近局部动态,第 2 层更接近抽象计划。原论文的图没有显式动作输入,但如果把它扩展成 action-conditioned world model,动作或动作序列应该进入 predictor,而不是只在最后接一个 policy head。
从视频训练框架拓展到 H-JEPA 世界模型
如果从现有视频训练框架出发,H-JEPA 给出的不是“再加一个视频 decoder”,而是一条表征预测路线。
1 | 历史视频片段 x |
和视频生成模型相比,关键改造是:
| 改造点 | 视频生成训练 | H-JEPA 式世界模型训练 |
|---|---|---|
| 预测对象 | future frames / video latents | future representations |
| 目标函数 | 重建、去噪或 token likelihood | representation prediction + anti-collapse regularization |
| 不确定性 | 通过噪声、自回归采样或 diffusion trajectory 表达 | 通过受限 latent variable 表达 |
| 长时序 | 常靠长上下文、记忆或分块生成 | 靠层级表征和多尺度预测降低细节负担 |
| 动作条件 | 常作为额外 condition 注入生成器 | 应进入 predictor,学习 action-conditioned dynamics |
| 可视化 | 直接输出视频 | 默认不输出画面,必要时再接 decoder |
这条路线和 LingBot-World 的视频生成路线不冲突,但目标不同。LingBot-World 需要生成可交互画面,因此视觉质量、实时性和长时一致性是核心约束。H-JEPA 更关注内部状态是否可预测、可规划、可组合;它可以作为视频世界模型的 latent dynamics 层,也可以作为机器人或自动驾驶系统的 state abstraction 层。
和 Dreamer / V-JEPA / LingBot 的关系
| 维度 | H-JEPA / latent EBM route | Dreamer route | V-JEPA route | LingBot route |
|---|---|---|---|---|
| 主要目标 | 在 representation space 中学习多尺度世界预测 | 从交互轨迹学习 latent dynamics 并训练 policy | 用视频自监督学习强视觉表征 | 从视频生成模型扩展成交互式世界模拟器 |
| 数据接口 | 可来自多模态配对、视频片段或交互轨迹 | 轨迹 | 视频 clip 和 mask | 大规模视频与交互控制数据 |
| 动作建模 | 原文是架构原则,动作可作为 predictor 条件扩展 | 动作是 RSSM transition 的核心条件 | 原论文没有 action | 动作/控制信号用于视频 rollout |
| 输出 | future representation / low-energy state | latent state、reward、continuation、policy | masked region representation | future video / interactive scene |
| 训练重点 | anti-collapse、latent capacity、层级预测 | KL、reward/continuation、imagination actor-critic | EMA target encoder、3D masking、latent regression | action grounding、causalization、long-horizon consistency |
最容易混淆的是 H-JEPA 和 V-JEPA。V-JEPA 是一个实证视频表征学习方法,给出了具体数据、mask、EMA target encoder、loss 和实验。H-JEPA 这篇文章则更基础:它解释为什么 JEPA 需要 regularized loss、为什么 latent variable 不能无限大、为什么长期世界模型需要层级抽象。
训练细节可复用点
这篇文章没有给出完整的 batch size、optimizer、训练步数和 benchmark recipe,但它给了几条很适合迁移到世界模型训练的原则。
第一,不能只压低正样本能量。无论是视频世界模型还是机器人 latent dynamics,如果 loss 只奖励“训练对匹配”,模型可能扩大低能量区域,导致反事实预测不可用。
第二,表征预测必须配 anti-collapse 机制。EMA teacher、variance/covariance regularization、stop-gradient、信息瓶颈和 latent capacity penalty 都是这个问题的不同实现方式。
第三,latent variable 应该表达不可观测但有用的不确定性,而不是成为答案缓存。工程上需要限制 的维度、噪声分布、互信息或可访问目标信息。
第四,长期 rollout 应该提高抽象层级,而不是强行保留短期细节。H-JEPA 的层级结构对应世界模型里的多尺度状态:底层负责局部物理和短期运动,高层负责任务进度、可达性和规划约束。
第五,动作条件要进入 dynamics predictor。如果只是训练 ,模型学到的是被动观察世界;如果要服务规划,训练样本必须让模型看到不同动作导致的不同未来。
局限与不可外推结论
这篇文章适合用来理解 H-JEPA 的训练思想,但不能当作 H-JEPA 已经被大规模验证的证据。
具体边界包括:
- 它是 lecture-note 风格论文,没有 H-JEPA benchmark、数据配方或消融实验;
- 图中的 H-JEPA 是概念架构,不是可直接复现的工程系统;
- 原文没有给出 action-conditioned predictor 的完整训练算法;
- cost/critic 如何学习、如何和任务奖励或人类目标对齐,仍是开放问题;
- representation-space prediction 可能丢掉规划需要的细节,例如小物体、接触状态、危险区域或可操作 affordance。
更稳妥的读法是:把这篇论文当成“表征型世界模型如何训练”的原则说明。它补充了 Dreamer 系列偏 RL recipe、V-JEPA 偏视频表征、LingBot 偏视频生成系统的部分,重点回答一个更底层的问题:世界模型的 latent space 如何既可预测、又不坍缩、还能支持长时层级规划。
阅读结论
读 H-JEPA 的价值在于抽象层级和 planning 接口:低层预测局部 latent,高层预测抽象状态,再用 energy/regularization 防 collapse。这里多数图是机制和架构证据,不是大规模 benchmark;不能拿来声称某个机器人任务已经被解决。
它的可复用机制是 representation-space prediction 的训练原则:anti-collapse、latent capacity、层级抽象和能量函数。不可外推项是原文没有给出 action-conditioned predictor 的完整工程 recipe,也没有真实控制 benchmark;更适合作为理解 JEPA/H-JEPA 思想的理论入口。
相关阅读与下一步
- 外部材料:论文标题 arXiv 检索。
- 外部材料:Semantic Scholar 标题检索。
- 外部材料:Papers with Code 检索。
- 站内下一步:论文精读专题。
- Title: 论文专题讲解:H-JEPA:层级 JEPA 与潜变量 EBM
- Author: Charles
- Created at : 2025-11-04 09:00:00
- Updated at : 2025-11-04 09:00:00
- Link: https://charles2530.github.io/2025/11/04/ai-files-paper-deep-dives-world-models-h-jepa/
- License: This work is licensed under CC BY-NC-SA 4.0.